Anthropicが2026年9月28日にリリースしたClaude Sonnet 5.5は、前モデルのClaude Sonnet 5と同じAPI単価のまま出力速度を30%以上高速化し、タスクあたりのコストを最大30%削減した中位モデルです。Boxでは処理速度が2.4倍に向上し、Zendeskではチケット処理が20%高速化するなど、導入企業から具体的な成果が報告されています。
しかし、Claude Sonnet 5.5とはそもそもどのようなモデルなのか、Opus 5.5とはどう使い分ければよいのか、Sonnet 5からの移行で何に注意すべきか、といった疑問を持つ方も多いのではないでしょうか。
本記事では、Claude Sonnet 5.5の概要・料金・ベンチマーク性能から、Opus 5.5との使い分け、使い方、API移行時の注意点まで、JAPAN AIが網羅的に解説します。
\ ChatGPTもClaudeもGeminiも使える! /

Claude Sonnet 5.5とは?
Claude Sonnet 5.5は、Anthropicが2026年9月28日にリリースしたClaude 5.5ファミリーの中位モデルです。前モデルであるClaude Sonnet 5の後継として、同じAPI単価を維持しながら出力速度を30%以上向上させ、タスクあたりのコストを最大30%削減しています。
Anthropicのモデルラインナップは、最上位のFable(Mythosクラス)、上位のOpus、中位のSonnet、軽量のHaikuという4つのティアで構成されています。公式発表ではClaude Sonnet 5.5の位置づけを「Opus 5.5を補う、より速く低コストなモデル」と説明しており、Opus 5.5が慎重な判断を要する複雑な仕事に向いているのに対し、Sonnet 5.5は範囲が明確な日常業務を速くこなすことに最適化されています。なお、最上位のFableクラスは大規模・長時間の自律的エージェント作業向けの別ラインであり、Sonnet 5.5とは用途が異なります。
具体的には、バグ修正や仕様が決まった実装、文書・スライド・表計算の作成、反復的なエージェント作業など、やるべきことが明確なタスクで高い費用対効果を発揮します。なお、Anthropicは数週間以内にHaiku 5.5の追加も予告しており、Claude 5.5ファミリーは今後さらに拡充される見込みです。
Claude Sonnet 5.5は、主要LLMの中でもコストパフォーマンスに優れた選択肢として、日常的なAI活用の中核を担うモデルといえます。
Sonnet 5からの主な変更点
Claude Sonnet 5.5は、Sonnet 5から速度・コスト効率・セキュリティの3つの軸で改善されています。主な変更点は以下のとおりです。
- 出力速度が30%以上向上し、Sonnetモデルとして最速を実現
- 同じ作業に必要なトークン量が減少し、タスクあたりのコストを最大30%削減
- サイバーセキュリティ機能を強化し、Sonnet初のフォールバック機構を搭載
- adaptive thinkingが既定で有効化され、effortレベルに応じた推論の深さを自動調整
- API料金は据え置き(100万トークンあたり入力$2、出力$10)
特に注目すべきは、トークン単価そのものは変わっていない点です。「最大30%安い」という表現は、同じ仕事を完了するために消費するトークン量が減ることによるタスク単価の低下を意味しています。つまり、1トークンあたりの料金は同じでも、より少ないトークンで同等以上の成果を出せるため、実質的なコスト削減が実現されています。
出典:Anthropic「Introducing Claude Sonnet 5.5」

Claude Sonnet 5.5の料金
Claude Sonnet 5.5のAPI料金は、Sonnet 5と同額でありながらOpus 5.5の半額という価格設定です。以下の料金比較表で、各モデルの単価を確認しましょう。
| 項目 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| 入力(100万トークンあたり) | $2 | $2 | $4 |
| 出力(100万トークンあたり) | $10 | $10 | $20 |
| キャッシュ読み取り(100万トークンあたり) | $0.20 | $0.20 | $0.20 |
表のとおり、Sonnet 5.5の入力単価はOpus 5.5の半額、出力単価も半額です。さらに、Sonnet 5.5は同じ作業に必要なトークン量自体が減少しているため、表示単価以上のコスト差が生まれます。
Anthropicの公式発表では「タスクあたり最大30%のコスト削減」とされていますが、この「最大」はAnthropicの社内テストでの上限値です。実際の削減幅は、作業内容やeffort設定、ツール構成によって変わります。公式発表によると、LowからMediumのeffort設定ではSonnet 5の最高スコアをタスクあたり約10分の1のコストで上回るケースもあるとされています。
コスト削減の仕組みを整理すると、トークン単価の値下げではなく、モデルの効率化によって同じ仕事に使うトークン量やツール呼び出し回数が減ったことによる実質的な削減です。たとえば、Sonnet 5で1,000トークンを消費していた作業が、Sonnet 5.5では700トークン程度で完了するケースがあるということです。
日常的なコーディングや文書作成を大量に処理する場合、Sonnet 5.5はOpus 5.5と比較して半額の単価と少ないトークン消費の両方で費用を抑えられるため、コスト効率を重視する開発チームにとって有力な選択肢です。Claudeの料金プラン全体の比較については、関連記事で詳しく解説しています。
出典:Anthropic「Introducing Claude Sonnet 5.5」
Claude Sonnet 5.5の性能とベンチマーク
Claude Sonnet 5.5は、Anthropic公式発表のベンチマークにおいてSonnet 5から大幅に性能が向上し、一部の指標では最高スコアがOpus 5.5を上回る結果を示しています。以下の表に主要ベンチマークの結果を整理します。
| ベンチマーク | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6%(Max effort) | 10.3% | 66.4%(Xhigh effort) |
| FrontierCode 1.1(Max / Xhigh) | 46.2% / 52.1% | 42.4% | 54.4% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 |
| OSWorld 2.1 | 80.1% | 57.0% | 81.8% |
| Humanity’s Last Exam | 64.5% | 54.9% | 67.7% |
| Chartography | 61.6% | 15.6% | 64.4% |
Terminal-BenchではSonnet 5.5の最高スコア(70.6%、Max effort)がOpus 5.5の最高スコア(66.4%、Xhigh effort)を上回っています。ただし、これは異なるeffort設定同士の比較であり、同一条件での比較ではない点に注意が必要です。GDPval-AAではほぼ同等のスコアであり、残りの5項目(FrontierCode、CursorBench、OSWorld、Humanity’s Last Exam、Chartography)ではOpus 5.5がSonnet 5.5を上回っています。すべてAnthropicの自己報告値である点にも留意してください。
GDPval-AAについては、Artificial Analysisがプレリリース版で評価しており、構造化出力の不具合修正前のため、Sonnet 5.5のスコアが低めに出ている可能性があるとAnthropicは注記しています。この不具合はすでに修正済みです。
Sonnet 5からの伸びは全ベンチマークで顕著であり、中位モデルでありながら上位モデルに迫る性能を実現している点が、Claude Sonnet 5.5の大きな特徴です。
コーディングでの伸び
コーディング領域では、Claude Sonnet 5.5はTerminal-Bench 4.0で10.3%から70.6%(Max effort、タスクあたり約$12.54)へと大きく向上し、Opus 5.5の最高スコア66.4%(Xhigh effort、タスクあたり約$7.35)を上回りました。ただし、この比較はeffort設定・コストが同一条件ではない点に注意が必要です。
公式発表のコストチャートによると、effort別のスコアは以下のように推移します。Medium effort(Claude appsとClaude Codeの既定値)ではOpus 5.5が57.6%に対しSonnet 5.5は28.8%と、Opus 5.5が大きく上回ります。Sonnet 5.5がOpus 5.5を上回るのはMax effortのみであり、そのタスクあたりコストはOpus 5.5のXhigh($7.35)より約71%高い$12.54です。
つまり、Terminal-Benchの結果は「Sonnet 5.5が常に低コストでOpus 5.5に匹敵する」ことを意味するものではなく、effort設定次第で優劣もコスト効率も変わります。既定のMedium effortで使う場合はOpus 5.5が明確に優位であり、Sonnet 5.5の強みはSonnet 5との比較で発揮されます。Medium effortでもSonnet 5の最高スコアをタスクあたり約10分の1のコストで上回るため、Sonnet 5からの乗り換え先としての価値は高いといえます。
FrontierCode 1.1ではSonnet 5.5のXhigh(52.1%)がMax(46.2%)より高いスコアを記録しており、effortを上げすぎるとかえってスコアが下がる場合があることがわかります。Xhighでも Opus 5.5(54.4%)には2.3ポイント届いていません。CursorBench 4.0でもOpus 5.5(57.8%)がSonnet 5.5(55.5%)を上回っています。
これらの結果を総合すると、Sonnet 5.5はSonnet 5から劇的に性能が向上した一方、Opus 5.5との比較ではeffort設定とコストのトレードオフを考慮する必要があります。Claude Codeの使い方については、関連記事もあわせてご覧ください。
出典:Anthropic「Introducing Claude Sonnet 5.5」
Opus 5.5とどう使い分ける?
Claude Sonnet 5.5とOpus 5.5の使い分けは、「定型はSonnet、判断はOpus」という基準で整理できます。Sonnet 5.5は範囲が明確な日常業務に、Opus 5.5は方針から考える必要がある複雑な仕事に、それぞれ適しています。
料金面では、Sonnet 5.5の入力単価$2・出力単価$10に対し、Opus 5.5は入力$4・出力$20と2倍の差があります。さらにSonnet 5.5はトークン消費量自体が少ないため、同じeffort設定であれば実質的なコスト差はさらに広がります。
以下の作業別比較表で、どちらのモデルを選ぶべきかを確認しましょう。
| 作業タイプ | 推奨モデル | 理由 |
|---|---|---|
| 修正範囲が決まったバグ修正 | Sonnet 5.5 | 完了条件が明確で、速度とコスト効率が重要 |
| 文書・スライド・表計算の作成 | Sonnet 5.5 | 仕様に沿った定型的な生成タスク |
| 反復的なコードレビュー | Sonnet 5.5 | チェック項目が決まっている反復作業 |
| 設計方針の検討 | Opus 5.5 | 複数の選択肢を比較し判断する必要がある |
| 要件があいまいな調査 | Opus 5.5 | 探索的な推論と長時間の思考が求められる |
| 長時間の判断を伴うリファクタリング | Opus 5.5 | 影響範囲が広く、失敗の損失が大きい |
Anthropic自身も「複雑で自由度の高い作業ではOpus 5.5が明確に強い」と説明しており、すべてのタスクをSonnet 5.5に置き換えることは推奨していません。タスクの性質に応じて適切に使い分けることで、品質とコストの両方を最適化できます。
Sonnet 5.5が向いている作業
Claude Sonnet 5.5は、修正範囲が決まっているバグ対応や仕様がはっきりした実装、文書やスライドの作成、速さが求められる反復作業に適しています。
Sonnet 5.5がこれらの作業で強みを発揮する理由は、出力速度の向上とトークン効率の改善にあります。やるべきことが明確なタスクでは、モデルが長時間の推論を行う必要がなく、Sonnet 5.5の高速な応答がそのまま生産性の向上につながります。
Anthropicの公式発表では、導入企業から以下の成果が報告されています。
- Box:金融・医療分野の実業務でSonnet 5より正確になり、2.4倍高速化、総トークン数を12%削減
- Zendesk:サポート対応で誤判断が減り、チケット処理が20%高速化
- Slack:既存プロンプトを変えずにほぼ全ての評価でSonnet 5を上回り、出力トークンを約14%削減
- Lovable:タスク完了までのツール呼び出しが約3分の1に減少、シェル実行は約半分に削減
これらの数値は、Sonnet 5.5が定型的な業務において速度・コスト・品質のすべてを改善できることを裏付けています。
出典:Anthropic「Introducing Claude Sonnet 5.5」
Opus 5.5に残したい作業
Opus 5.5に任せるべきなのは、設計の方針を決める作業や要件があいまいな調査、長時間の判断を伴う作業、失敗の損失が大きい変更です。
Opus 5.5がこれらのタスクで優位に立つ理由は、より深い推論能力にあります。複雑な判断を要する指標ではOpus 5.5がSonnet 5.5を一貫してベンチマークスコアが上回っています。Terminal-Bench 4.0でも、既定に近いMedium effortではOpus 5.5(57.6%)がSonnet 5.5(28.8%)を大きく上回っており、日常的な設定での推論力の差は明確です。
実務での判断基準としては、「タスクの完了条件を1文で書けるかどうか」が有効です。「このファイルのバグを修正する」「この仕様書に沿ってAPIを実装する」のように完了条件が明確ならSonnet 5.5、「このシステムのアーキテクチャを設計する」「この調査結果から戦略を提案する」のように判断の余地が大きいならOpus 5.5を選びましょう。
Claude(クロード)の特徴・料金・使い方とChatGPTとの違いについては、関連記事で詳しく解説しています。
AIモデルの使い分けを組織で実践するなら「JAPAN AI AGENT」
Claude Sonnet 5.5やOpus 5.5をはじめ、GPTやGeminiなど複数の最新AIモデルを業務内容に応じて切り替えられる環境を、ノーコードで構築できるのがJAPAN AI AGENTです。上場企業水準のセキュリティ体制のもと、社内文書の横断検索やツール連携による業務自動化まで、AIエージェントを活用した生産性向上を実現します。専任担当による伴走支援で、導入から定着までをサポートします。
日本企業のための
最も実用的なAIエージェントへ!
AIが企業の様々な職種の
方々が
普段行っている
タスクを自律的に実行
JAPAN AI AGENT
✓
実用性の高いAIエージェンを提供
✓
無料の伴走サポート
✓
高いカスタマイズ性
✓
目標設定をだけで自律的にAIが各タスクを実行
Claude Sonnet 5.5の使い方
Claude Sonnet 5.5は、Claudeのアプリ(Web・iOS・Android)およびClaude Codeで利用可能であり、APIモデルIDは「claude-sonnet-5-5」です。Claude Platformのほか、Amazon Web Services、Google Cloud、Microsoft Azureでも提供されています。
effortレベルはLow、Medium、High、Xhigh、Maxの5段階が用意されています。既定値はClaude appsとClaude CodeではMedium、Claude PlatformではHighです。低いeffortは応答が速くトークン消費も少ないため日常作業に向いており、高いeffortはより長く推論して確認を重ねるため、精度を求めるタスクに適しています。
Claude Codeでは、`/model`コマンドからモデルを選択するか、起動時に`claude –model claude-sonnet-5-5`と指定することで利用できます。APIを使わずClaude appsやClaude Codeのみで利用している場合は、モデル選択を切り替えるだけで移行コストなくSonnet 5.5を使い始められます。
途中でSonnet 5に切り替わる場合
Claude Sonnet 5.5は、Sonnet初のサイバーセキュリティフォールバック機構を搭載しています。エクスプロイト作成や脆弱性スキャン、ペネトレーションテストなどの高リスクな依頼を検出すると、同じ会話内でSonnet 5に自動的に切り替わります。
このフォールバックが導入された背景には、Sonnet 5.5のサイバー能力がOpus 5に匹敵するレベルに達したことがあります。高い能力を持つモデルが悪用されるリスクを低減するため、Opus 5.5と同様のサイバーセーフガードが適用されています。
切り替わった場合は通知が表示され、その会話ではSonnet 5のまま継続されます。設定からフォールバックをオフにすることも可能ですが、オフにすると会話が一時停止する仕組みです。通常のソフトウェア開発におけるバグ発見・修正は引き続きSonnet 5.5で実行できるため、一般的な開発業務に影響はありません。
より高度なサイバーセキュリティ機能へのアクセスが必要な場合は、AnthropicのCyber Verification Programへの申請が案内されています。
出典:Anthropic「Introducing Claude Sonnet 5.5」
Sonnet 5から移行するときの注意点
Claude Sonnet 5からSonnet 5.5へ移行する際には、APIリクエストの形式に関する5つの破壊的変更に注意が必要です。変更せずにリクエストを送信すると400エラーが返されるため、事前に確認しましょう。
- thinking設定の変更:`thinking: {“type”:”disabled”}`は400エラーを返す。`{“type”:”between_tools”}`に変更する(Low、Medium、Highのeffortで利用可能。XhighとMaxでは不可)
- tool_choiceの変更:`any`および`tool`は400エラーを返す。`auto`に変更し、strict tool useまたはstructured outputsを使用する
- 思考ブロックの紐付き:思考ブロックが生成モデル・会話に紐付くようになり、履歴を編集して再送すると400エラーが発生する場合がある。会話履歴は追記専用で運用する
- 旧computer useツールの廃止:`computer_20251124`はClaude APIおよびGoogle Cloudで400エラーを返す。`computer_toolset_20260801`に変更する(Amazon Bedrockでは旧ツールも引き続き利用可能)
- advisorツールの制限:Opus 4.8、Opus 4.7、Sonnet 5をadvisorに指定すると400エラーが発生する
加えて、ツール呼び出し間のテキストがthinkingブロックで返される形式変更があります。リクエスト自体は失敗しませんが、ストリーミング表示に影響する場合があるため、表示処理を確認してください。
移行作業で最も多くの利用者に影響するのは、1つ目のthinking設定の変更です。`thinking: disabled`を使っている箇所を`between_tools`に書き換えることを最優先で対応しましょう。
出典:Claude Platform Docs「Claude Sonnet 5.5 Overview」
Sonnet 5から乗り換えるべき人・待つべき人
Sonnet 5からSonnet 5.5への乗り換えは、利用形態とAPI設定の2つの軸で判断できます。以下に、乗り換えてよいケースと検証してから判断すべきケースを整理します。
乗り換えてよいケースは以下のとおりです。
- APIを使っていない(Claude appsやClaude Codeのみ):モデル選択を切り替えるだけで移行コストがかからない
- APIを使っているが`thinking: disabled`や`tool_choice: any/tool`を使っていない:モデルIDの変更のみで移行可能
- 新規プロジェクト:同価格のためSonnet 5を選ぶ理由がない
一方、検証してから判断すべきケースは以下のとおりです。
- `thinking: disabled`を使っている:`between_tools`への書き換えが必要であり、推論の挙動が変わる可能性がある
- `tool_choice`で強制ツール呼び出しをしている:`auto`への変更とプロンプト調整が必要
- 既存プロンプトの出力形式に依存した下流処理がある:出力スタイルの変化が後続の処理に影響しないか検証が必要
検証が必要なケースでは、代表的なタスクを20〜30件選び、Sonnet 5とSonnet 5.5の両方で実行して合格率・トークン使用量を比較してから切り替えるのが安全です。同価格のモデルであるため、検証で問題がなければ早期に移行するメリットが大きいといえます。
Claude Sonnet 5.5に関してよくある質問
Claude Sonnet 5.5の料金はいくらですか?
API料金は100万トークンあたり入力$2、出力$10で、Sonnet 5と同額です。Opus 5.5(入力$4、出力$20)の半額にあたります。
表示単価は同じですが、同じ作業に使うトークン量が減るため、Anthropicのテストではタスクあたり最大30%安くなるとされています。キャッシュ読み取りは100万トークンあたり$0.20です。
Sonnet 5.5とOpus 5.5はどちらを使えばいいですか?
範囲が明確な日常業務にはSonnet 5.5、あいまいで判断が必要な仕事にはOpus 5.5を選びましょう。
迷った場合は、同じ依頼を両方のモデルに出して出力を比較するのが確実です。Sonnet 5.5で十分な品質が得られるタスクであれば、半額の単価と少ないトークン消費で大幅なコスト削減が見込めます。
Sonnet 5からの移行で最初に確認すべきことはなんですか?
`thinking: disabled`を使っている箇所を`between_tools`に変更してください。これが最も多くの利用者に影響する破壊的変更です。
変更せずにリクエストを送信すると400エラーが返されます。`between_tools`はLow、Medium、Highのeffortレベルで利用可能ですが、XhighとMaxでは使用できない点にも注意が必要です。
Claude Sonnet 5.5は「定型はSonnet、判断はOpus」で使い始めよう
Claude Sonnet 5.5は、Sonnet 5と同じ料金で出力速度30%以上の向上とタスクあたり最大30%のコスト削減を実現した中位モデルです。ベンチマークではSonnet 5から全指標で大幅に向上しており、既定のMedium effortでもSonnet 5の最高スコアを大きく上回ります。
使い分けの基本は「定型はSonnet 5.5、判断はOpus 5.5」です。範囲が明確なバグ修正や仕様どおりの実装、文書・スライド・表計算の作成にはSonnet 5.5を、設計方針の決定やあいまいな調査、慎重なレビューにはOpus 5.5を選びましょう。
まずは既存のSonnet 5で回している作業をSonnet 5.5に差し替え、レイテンシとトークン使用量を1日分記録することをおすすめします。移行時には、thinking設定の変更(`between_tools`への書き換え)を忘れずに対応してください。
Claude Sonnet 5.5の性能やOpus 5.5との使い分けについてさらに詳しく知りたい方は、以下の記事もご覧ください。
JAPAN AIとは
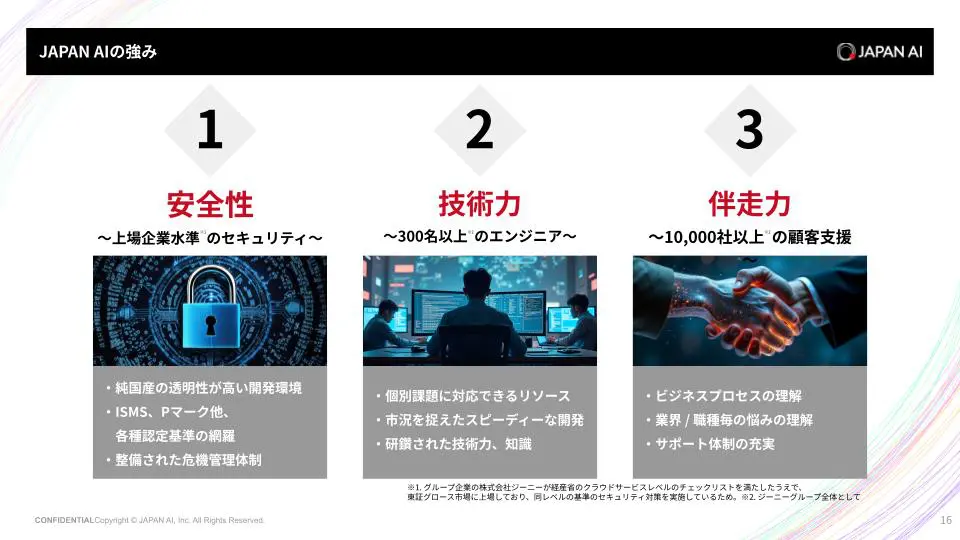
JAPAN AIは、法人向けの国産生成AIプラットフォームです。AIチャット・議事録・エージェントなどのすぐ使える標準機能から、自社専用AIアプリのノーコード開発まで、全部門のAI活用をひとつの基盤で支えます。ジーニーグループのこれまでのDX・AX支援実績をもとに、ツールの提供にとどまらず、活用テーマの設計から現場での定着・成果創出まで専門チームが伴走します。
JAPAN AIの機能・活用事例・料金体系がわかるサービス紹介資料を無料でお送りします。
▼資料イメージ
- JAPAN AIでできること(AIチャット/議事録/エージェント/アプリ開発 ほか)
- ChatGPTなど汎用AIツールとの違い
- 業種・部門別の活用シーンと導入事例
- 導入から定着までの支援体制
- 料金体系とセキュリティ・ガバナンス対応
▼簡単1分!JAPAN AIの資料請求