面接評価のばらつきとは、同じ候補者を面接しても、面接官によって評価や合否判断が大きく異なってしまう状態を指します。採用の質や公平性を左右する問題として関心が高まっています。厚生労働省「公正な採用選考の基本」でも、面接ではあらかじめ質問項目や評価基準を決めておき、できるだけ客観的かつ公平に評価するよう呼びかけています。
しかし、面接評価のばらつきはなぜ起こるのか、評価基準や評価シートはどう設計すればよいのか、構造化面接や面接官トレーニングにはどの程度の効果があるのか、といった疑問を持つ方も多いのではないでしょうか。
本記事では、面接評価のばらつきの原因から、評価基準の設計や構造化面接、そしてデータ活用による改善方法まで、AI面接ツールを提供するJAPAN AIが網羅的に解説します。
\ ChatGPTもClaudeもGeminiも使える! /

面接評価のばらつきが企業にもたらす損失
面接評価のばらつきは、評価が合わないという現場の問題にとどまりません。企業には採用精度の低下、候補者体験の悪化、面接官の負担増加という3つの損失が生じます。
1つ目の採用精度の低下は、合否が候補者の能力よりも「誰が面接したか」に左右されることで起こります。評価の観点が面接官ごとに違うと、入社後に活躍できる人材を落とす一方で、自社に合わない人材を通過させる判断も起こりやすくなります。その結果、早期離職や再募集の手間が増え、採用にかかるコストがかさみます。
2つ目の候補者体験の悪化は、面接官によって質問内容も評価の観点も異なる状況から生まれます。候補者は「何を基準に見られているのかわからない」と感じ、企業の採用基準そのものに不信感を抱くでしょう。複数の企業を並行して受ける候補者にとっては、選考に一貫性があるかどうかも企業を比べる材料の一つです。
3つ目は面接官の負担増加です。判断基準が明確でないと、面接官は毎回「何をどう評価すべきか」をゼロから考えなければなりません。迷った末に印象で判断する場面が増えれば属人化が進み、ばらつきがさらに広がるという悪循環に陥ります。
面接評価のばらつきは採用コストと企業の信頼性に直結する経営課題として捉え、仕組みで改善を図りましょう。
候補者へのURL送信からAI面接の実施・評価レポート作成、ATS連携まで。24時間365日対応で一次面接を自動化し、評価基準の標準化と選考スピードの向上を実現するAI面接プラットフォーム「JAPAN AI HR」。⇒AI面接サービスの詳細を見る
面接評価のばらつきが起こる原因
面接評価のばらつきは、面接官個人のセンスや経験不足が原因と思われがちです。しかし実際には、評価基準や質問設計、記録・共有の仕組みが整っていないことに起因する場合が少なくありません。主な原因は次の5つです。
- 評価基準が言語化されていない
- 質問内容が面接官ごとに違う
- 認知バイアスの影響
- 記録が主観メモ中心になっている
- 面接官同士のすり合わせ機会がない
いずれも面接官個人の努力だけでは解消しにくく、組織として仕組みを整えることで初めて改善できる原因です。自社の選考がどの原因にあてはまるかを確認すると、優先して手を打つべき対策が明確になります。
評価基準が言語化されていない
評価項目の定義が言語化されていないと、面接官ごとに解釈が分かれ、同じ評価項目でも測っている中身がずれることが、面接評価のばらつきを生む最も根本的な原因です。
たとえば「コミュニケーション力」という評価項目があっても、ある面接官は「明るくハキハキ話せること」と捉え、別の面接官は「質問の意図を汲み、論理的に説明できること」と捉えるケースがあります。このとき、同じ候補者の同じ回答を聞いても、前者は話し方の印象を、後者は回答の構成を評価しています。点数が食い違うのは、面接官の能力差ではなく、評価の物差しそのものが違うためです。「主体性」や「リーダーシップ」のような抽象度の高い言葉ほど、解釈の幅は広がります。
評価項目を設けるだけで終わらせず、「どのような言動が見られたら高く評価するのか」まで言葉にしておくことで、面接官全員が同じ物差しで候補者を見られるようになります。
質問内容が面接官ごとに違う
面接官が各自の判断で自由に質問すると、候補者ごとに聞かれる内容や難易度が変わり、候補者同士を同じ条件で比較できなくなります。
たとえば、ある候補者には「これまでで最も困難だった仕事」を深く掘り下げ、別の候補者には志望動機を中心に聞いたとします。前者は課題解決力を示す機会を得ますが、後者はその機会がないまま評価されます。結果として、評価結果には候補者の実力差だけでなく「どの質問をされたか」の差が混ざってしまいます。
また、面接官が得意な話題や関心のあるテーマに質問が偏ると、評価項目の一部が確認されないまま合否が決まることもあります。
質問を面接官任せにせず、評価項目ごとに確認すべき質問を揃えておくことで、候補者を公平な条件で比べられるようになります。
認知バイアスの影響
面接官は誰でも無意識のうちに認知バイアス(思い込みによる判断のゆがみ)の影響を受けており、「気をつけよう」という意識だけでは防げない点がばらつきの原因になります。面接で起こりやすい代表的なバイアスは次のとおりです。
- 初頭効果:最初に受けた印象が、その後の評価全体を左右する
- 確証バイアス:自分の仮説を裏付ける情報ばかりを拾ってしまう
- ハロー効果:一つの際立った特徴が、ほかの項目の評価まで引き上げたり引き下げたりする
- 類似性バイアス:自分と経歴や価値観が似た候補者を高く評価してしまう
これらのバイアスは、面接官の経験や価値観によって働き方が異なるため、同じ候補者でも評価が分かれる原因になります。例を挙げると、出身大学や前職が自分と同じ候補者に好印象を抱いた面接官は、ほかの面接官よりも評価が甘くなりがちです。
バイアスを個人の心がけで抑えるのには限界があります。行動ベースの評価基準や共通質問など、判断の余地を狭める仕組みで対策しましょう。
記録が主観メモ中心になっている
面接記録が「印象が良かった」「少し物足りない」といった主観的なメモにとどまっていると、判断根拠をほかの面接官と共有できないため、評価のずれを検証できません。
根拠のない記録では、評価会議で「なぜその点数を付けたのか」を説明できず、議論が感覚のぶつけ合いになります。すると、声の大きい面接官や役職が上の面接官の意見が通りやすくなり、属人的な判断がそのまま組織の結論として固定されてしまいます。また、次の選考段階の面接官に申し送る情報も曖昧になり、確認すべき懸念点が引き継がれないまま選考が進むこともあります。
候補者の具体的な発言や行動を記録に残すことで、評価の妥当性を後から検証でき、面接官同士の判断のずれにも気づけるようになります。
面接官同士のすり合わせ機会がない
面接官同士で評価の観点や合格ラインを確認し合う場がないと、認識がずれたまま選考が進み、面接評価のばらつきが放置されます。
評価基準を文書化していても、その読み取り方は人によって異なります。「5段階評価の4はどの程度の水準か」「この回答は主体性の根拠として十分か」といった解釈の細部は、実際の候補者の評価を突き合わせて初めてずれが見えてきます。チャットツールで面接結果を簡単に報告し合っているだけでは、結論は共有できても、判断の根拠や水準までは揃いません。
定期的に評価の根拠を突き合わせる場を設けることで、面接官ごとの甘さ・厳しさの差を早期に把握し、選考全体の判断水準を揃えられます。
候補者へのURL送信からAI面接の実施・評価レポート作成、ATS連携まで。24時間365日対応で一次面接を自動化し、評価基準の標準化と選考スピードの向上を実現するAI面接プラットフォーム「JAPAN AI HR」。⇒AI面接サービスの詳細を見る
面接評価のばらつきを減らすための評価基準の設計
面接評価のばらつきを仕組みで抑えるには、まず誰が面接しても同じ評価軸で候補者を見極められる評価基準を設計することが欠かせません。面接を製造現場の品質管理と同じ発想で捉え、判断の手順と基準を標準化します。評価基準の設計では、次の4つに取り組んでください。
- 評価項目を3〜5項目に絞る
- 各評価項目の定義を行動ベースにする
- 質問を標準化する
- 評価段階と判断基準を具体化する
4つを組み合わせることで、面接官の経験や価値観に左右されにくい評価の仕組みをつくれます。
評価項目を3〜5項目に絞る
評価基準の設計では、まず評価項目を採用ポジションに直結する3〜5項目に絞り込むことが、面接評価のばらつきを抑える第一歩として有効です。
評価項目が多すぎると、限られた面接時間ですべてを深く確認できません。たとえば60分の面接で10項目を評価しようとすると、1項目あたりに使える時間は数分程度にとどまり、確認しきれなかった項目を面接官が印象で埋めることになります。これがばらつきを生む温床です。
反対に「職務理解」「対人コミュニケーション」「主体性」などに絞り込めば、1項目ごとに質問と深掘りの時間を確保でき、評価の根拠も集めやすくなります。
項目を選ぶ際は、そのポジションで成果を上げている社員に共通する行動や、過去の採用でミスマッチが起きた理由を振り返りましょう。自社にとって本当に見極めるべき項目が浮かび上がります。
各評価項目の定義を行動ベースにする
評価項目を絞ったら、各項目について「どの行動が観察されたら何点を付けるか」を行動アンカー(評価の目安となる具体的な行動例)として定義します。以下は「対人コミュニケーション」の行動アンカーの例です。
| スコア | 行動の基準 |
|---|---|
| 5 | 相手の発言を正確に要約し、自分の考えを具体例とともに論理的に説明した |
| 4 | 質問の意図を理解し、根拠を添えて自分の考えを述べた |
| 3 | 質問に対して的確に回答したが、具体例の提示が不十分だった |
| 2 | 回答が抽象的で、質問の意図と一部ずれがあった |
| 1 | 質問の意図を汲み取れず、一方的に話し続けた |
「コミュニケーション力が高い」といった抽象的な表現ではなく、観察できる行動で基準を書くことで、面接官は自分の解釈ではなく候補者の実際の言動を基準表に照らして点数を付けられます。
行動ベースの定義は、面接官ごとの解釈のずれを小さくするだけでなく、新しく加わった面接官でも短期間で同じ水準の評価ができる状態をつくれます。
質問を標準化する
質問の標準化とは、すべての候補者に共通して聞く質問を事前に設計し、評価項目とひも付けておくことです。候補者を同じ条件で比較できるようにすることが目的です。
たとえば「主体性」を測りたい場合は、「これまでに自ら課題を見つけ、改善に取り組んだ経験を教えてください」という質問を全員に投げかけます。同じ問いに対する回答であれば、候補者ごとの行動の違いをそのまま比べられます。評価項目ごとに質問を割り当てておけば、確認漏れも防げます。近年はAI面接を活用し、設計した質問を全候補者に同じ流れで実施する企業も見られます。
質問の標準化は公平性の観点からも求められています。厚生労働省は、面接では職務遂行に必要な適性・能力を評価する観点から、あらかじめ質問項目や評価基準を決めておき、適性と能力に関係のない事項を尋ねないよう留意することを求めています。本籍・出生地や家族に関すること、宗教や支持政党に関することなどは、把握すべきでない事項として挙げられています。
質問を事前に設計しておけば、比較のしやすさが高まるだけでなく、不適切な質問による就職差別のリスクも抑えられます。
評価段階と判断基準を具体化する
5段階評価を機能させるには、各段階の違いと合否の判断ラインを明文化することが必要です。
段階の定義が曖昧だと、ある面接官は「標準的なら3」、別の面接官は「標準的なら4」と付けるように、同じ水準の回答でも点数がずれます。とくに迷いやすいのが「3と4の境目」です。「具体例を伴って説明できたか」「成果を数値や事実で示せたか」のように、隣り合う段階を分ける条件を一文で示しておくと判断が安定します。
また、数値評価だけでなく、根拠となった候補者の具体的な発言や行動をコメント欄に記載することを必須にしましょう。点数と根拠がセットで残れば、評価会議で判断の妥当性を検証できます。
段階の境目と根拠の記載ルールを決めておくことで、評価の透明性が高まり、候補者への説明責任も果たしやすくなります。
候補者へのURL送信からAI面接の実施・評価レポート作成、ATS連携まで。24時間365日対応で一次面接を自動化し、評価基準の標準化と選考スピードの向上を実現するAI面接プラットフォーム「JAPAN AI HR」。⇒AI面接サービスの詳細を見る
構造化面接の導入による精度向上
構造化面接とは、質問内容と評価方法をあらかじめ統一し、すべての候補者に同じ条件で面接を行う手法で、面接評価のばらつきを抑えながら採用の予測精度を高められる点が特長です。評価基準を設計したら、構造化面接を取り入れて面接の進め方そのものも改善しましょう。導入時に押さえたいポイントは次の3つです。
- 構造化面接の有効性と学術的根拠
- STAR法による行動ベースの質問設計
- 半構造化面接による柔軟性の確保
構造化面接は、学術的な裏付けのある手法を、自社の状況に合わせた柔軟さで運用できる点に強みがあります。
構造化面接の進め方や質問例については、「構造化面接とは?メリットデメリットや半構造化面接との違い・質問例」の記事で詳しく解説しています。
構造化面接の有効性と学術的根拠
構造化面接は、非構造化面接よりも入社後の職務成果を予測する精度が高いことが、複数のメタ分析(多数の研究結果を統合して分析する手法)で示されています。
構造化面接で予測精度が高まるのは、質問と評価基準が統一されることで、評価結果に含まれる「面接官ごとの癖」や「質問内容の違い」による誤差が減るためです。面接官が変わっても同じ物差しで評価されるため、点数の差が候補者の実力差をより正確に反映します。
SchmidtとHunterによる1998年のメタ分析では、職務成果の予測精度を示す妥当性係数(1に近いほど予測精度が高いことを示す指標)は、構造化面接で.51、非構造化面接で.38と報告されました。その後、Sackettらが2022年に発表した改訂版のメタ分析では、補正方法を見直した結果、構造化面接が.42、非構造化面接が.19と推定されています。改訂版では構造化面接の係数が非構造化面接の2倍以上となり、両者の差はより大きく示されました。
推定値は研究によって異なりますが、構造化面接が非構造化面接を上回るという結論は一貫しています。採用の精度を高めたい場合は、面接の構造化から着手しましょう。
出典:American Psychological Association「The validity and utility of selection methods in personnel psychology: Practical and theoretical implications of 85 years of research findings」
出典:American Psychological Association「Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range」
STAR法による行動ベースの質問設計
STAR法とは、候補者の過去の行動を4つの要素に分けて引き出す質問の枠組みで、構造化面接において再現性のある行動パターンを評価できる点に価値があります。STAR法では、次の順序で質問を深めます。
- Situation(状況):どのような状況だったか
- Task(課題):そこでの役割や課題は何だったか
- Action(行動):具体的にどう行動したか
- Result(結果):行動の結果どうなったか
たとえば、「チームで意見が対立した経験」を聞く場合、状況・役割・行動・結果の順に掘り下げることで、「調整力があります」という抽象的な自己PRではなく、実際に取った行動を確認できます。過去の行動は将来の行動を予測する手がかりになるため、仮定の質問よりも評価の根拠として信頼性が高いと考えられています。また、4つの要素が質問の型として決まっているため、面接官による深掘りの度合いの差も小さくなります。
評価項目ごとにSTAR法の質問を用意しておきましょう。経験の浅い面接官でも、根拠のそろった評価ができるようになります。
半構造化面接による柔軟性の確保
半構造化面接とは、主要な質問は共通化しつつ、候補者の回答に応じた深掘り質問は面接官の裁量に委ねる手法で、公平性と柔軟性を両立できる点が特長です。
すべての質問と順序を固定する完全な構造化面接は、比較のしやすさに優れる一方で、候補者の経験に応じた掘り下げが難しく、面接が機械的な印象を与えることもあります。半構造化面接であれば、評価に使う共通質問で比較の前提を揃えたうえで、候補者特有の経験や強みを追加の質問で引き出せます。現場の面接官にとっても進め方の自由度が残るため、構造化面接への抵抗感が強い組織でも取り入れやすい方法です。
まずは評価項目ごとの共通質問だけを固定し、深掘りの仕方は運用しながら揃えていく進め方がおすすめです。
半構造化面接の質問例や実施の流れについては、「半構造化インタビューとは?定義からメリット・デメリット、質問例、実施の流れ」の記事もあわせてご覧ください。
候補者へのURL送信からAI面接の実施・評価レポート作成、ATS連携まで。24時間365日対応で一次面接を自動化し、評価基準の標準化と選考スピードの向上を実現するAI面接プラットフォーム「JAPAN AI HR」。⇒AI面接サービスの詳細を見る
面接評価シートの作り方と活用方法
面接評価シートとは、評価項目や評価基準、記録欄を1枚にまとめた面接現場で使うツールで、設計した評価基準を実際の面接で機能させる役割を担います。評価シートを整備する際は、次の3点を押さえましょう。
- 面接評価シートに入れる項目
- 評価コメントの書き方
- 評価シート作成時の注意点
「誰でも迷わず使える構造」と「根拠が記録に残る仕組み」を両立させることが、面接評価シートを形だけで終わらせないためのポイントです。
面接評価シートに入れる項目
面接評価シートには、評価基準と質問、記録欄を一体で参照できる構成を持たせることで、面接中の判断のぶれを抑えられます。盛り込みたい項目は次のとおりです。
- 評価項目と各項目の定義:3〜5項目に絞って記載する
- 5段階評価欄と行動アンカーの参照表:点数の目安をその場で確認できるようにする
- 理由記入欄:評価の根拠となった候補者の具体的な発言・行動を記録する
- 質問例の対応表:各評価項目に対してどの質問を使うかを示す
- 合否判断ガイド:合格の目安スコアと懸念パターンを明示する
これらを1枚にまとめておけば、面接官は別の資料を探すことなく、基準を確認しながら評価できます。とくに質問例の対応表と行動アンカーを同じシート上に置くと、「この質問で何を見るか」「どの回答なら何点か」がひと目でわかり、面接官による評価の差が生まれにくくなります。
項目を盛り込みすぎるとかえって使いにくくなるため、面接中に参照する部分は1ページに収まる分量に整えましょう。
評価コメントの書き方
評価コメントは、印象ではなく「何を聞き、何が観察され、なぜその評価にしたか」の流れで、行動と判断根拠をセットで記述します。
「印象が良い」「頼りない感じがした」といったコメントは、書いた本人以外には判断の根拠が伝わりません。たとえば「チーム内で意見が対立した場面について質問したところ、双方の意見を整理して代替案を提示した具体的なエピソードを語った。このため対人コミュニケーションを4と評価した」と書けば、ほかの面接官も同じ事実をもとに評価の妥当性を検討できます。懸念点を書く場合も、「主体性が弱そう」ではなく「自ら提案した経験を尋ねたが、具体例が出なかった」のように事実で記録します。
コメントの書き方を統一すると、評価会議の議論が事実ベースで進み、次の選考段階への申し送りの質も高まります。
評価シート作成時の注意点
評価シートは作って終わりではなく、面接官全員が使い方と基準の意味を共有して運用することで初めて効果を発揮します。
よくある失敗は、評価項目の数を増やしすぎることや、項目の定義が抽象的なまま運用を始めること、面接官間で解釈を揃える場を設けないことの3つです。項目が多すぎると記入の負担が増えて空欄や印象評価が増え、定義が抽象的なままでは結局面接官ごとの解釈に頼ることになります。さらに、シートを配布するだけで説明の場がなければ、各面接官が自己流で使い始めてしまいます。
導入時には説明会を開き、運用開始後も記入内容を定期的に見直してください。実態に合わせて項目や定義を改善し続けることで、評価シートの精度が高まります。
候補者へのURL送信からAI面接の実施・評価レポート作成、ATS連携まで。24時間365日対応で一次面接を自動化し、評価基準の標準化と選考スピードの向上を実現するAI面接プラットフォーム「JAPAN AI HR」。⇒AI面接サービスの詳細を見る
面接官トレーニングによる精度向上
面接官トレーニングとは、評価基準の理解と面接の進め方を面接官全員で揃えるための取り組みで、評価基準やシートを現場で使いこなせる状態をつくるために欠かせません。仕組みを整えても、使う側のスキルに差があれば期待した効果は得られません。面接官トレーニングで取り組みたい内容は次の3つです。
- 面接官トレーニングの目的と効果
- ロールプレイングによる実践的スキル習得
- 面接官間で評価の観点をすり合わせる
座学で目的を理解し、実践で技術を磨き、評価の目線を合わせる流れで進めることで、組織全体の面接の質を底上げできます。
面接官トレーニングの目的と効果
面接官トレーニングの目的は、評価基準の理解と運用スキルを面接官全員で揃えることにあります。主な目的は次のとおりです。
- 評価のばらつきを減らす
- 採用ミスマッチを防ぐ
- 候補者の納得度を高める
- 属人的な判断から脱却する
面接官は現場の管理職や社員が兼務することが多く、面接のやり方を体系的に学ぶ機会がないまま担当している場合も少なくありません。そのため、評価基準の意図や質問の深掘り方、記録の書き方が自己流になりがちです。トレーニングで「なぜこの評価項目を設けたのか」「どの行動を見ればよいのか」を共有すると、面接官は基準の背景まで理解したうえで判断できるようになります。
新任の面接官だけでなく、経験豊富な面接官も定期的に受講しましょう。経験者ほど自己流の癖が定着しているため、見直しの効果が大きいといえます。
面接官の育成については、「AI面接官の育成方法とは?仕組み・メリット・導入事例・最新トレンド」の記事もあわせてご覧ください。
ロールプレイングによる実践的スキル習得
ロールプレイング(役割演技)は、面接官トレーニングのなかでも実際の面接に近い状況で質問と評価の技術を磨ける手法です。
座学で評価基準を理解しても、実際の面接では候補者の回答に合わせて瞬時に深掘りし、同時に記録を取らなければなりません。この負荷のかかる状況を事前に体験しておくことが、本番での判断の安定につながります。ロールプレイングでは、優秀な候補者や回答が曖昧な候補者、話が逸れやすい候補者などを想定したシナリオを用意し、面接官役・候補者役・観察役を交代しながら進めます。
終了後は観察役や他の面接官からフィードバックを受け、自分では気づきにくい質問の癖や評価の偏りを把握しましょう。録画して見返すと、改善点をより具体的に確認できます。
面接官間で評価の観点をすり合わせる
面接官間で評価の観点をすり合わせるには、同じ面接を複数の面接官が独立して評価し、点数と根拠を突き合わせるキャリブレーション(評価目線の調整)が有効です。
具体的には、候補者の同意を得て録画した面接や、ロールプレイングの映像を素材にします。各面接官が評価シートを使って個別に採点し、その後に結果を持ち寄ります。点数が割れた項目について「なぜ自分は4を付けたのか」「なぜあの人は2を付けたのか」を議論すると、評価基準の解釈のずれが具体的に見えてきます。議論で合意した解釈は、行動アンカーや判断基準に追記して評価シートに反映させます。
キャリブレーションは一度で終わらせず、新しい面接官が加わったときや評価基準を見直したときに定期的に実施しましょう。1回あたり1時間程度を目安にすると、通常業務と両立しながら継続できます。
候補者へのURL送信からAI面接の実施・評価レポート作成、ATS連携まで。24時間365日対応で一次面接を自動化し、評価基準の標準化と選考スピードの向上を実現するAI面接プラットフォーム「JAPAN AI HR」。⇒AI面接サービスの詳細を見る
データ活用による面接評価の可視化と改善
データ活用とは、面接の評価結果を数値やコメントとして蓄積・分析し、面接評価のばらつきを客観的に把握して改善につなげる取り組みです。人材に関するデータを分析して人事の意思決定に活かすピープルアナリティクスの考え方を、面接評価にも応用します。データ活用の主な方法は次の2つです。
- 面接官ごとの通過率・合否傾向を集計する
- 評価コメントを質で比較する
数値とコメントの両面から面接評価を見ることで、ばらつきを「感覚」ではなく事実にもとづいて議論でき、改善の優先順位も判断しやすくなります。
面接官ごとの通過率・合否傾向を集計する
面接評価のばらつきを可視化する最初の手段は、面接官ごとの通過率と評価スコアの分布を集計することです。
一次面接や最終面接の通過率を面接官別に並べると、特定の面接官だけ通過率が極端に高い、あるいは極端に低いといった偏りが見えてきます。通過率が高すぎる面接官は評価が甘く、低すぎる面接官は厳しい傾向にある可能性があります。評価項目ごとのスコア分布をグラフにすると、「どの項目で甘辛の差が大きいか」まで特定できます。ただし、担当する職種や候補者層によって通過率が変わることもあるため、条件を揃えて比較することが大切です。
偏りが見つかった面接官には、データを示しながらキャリブレーションの場で基準を確認してください。数値という共通の材料があることで、指摘を感情的な対立にせず建設的な改善につなげられます。
評価コメントを質で比較する
数値だけではわからない面接官ごとの視点の違いは、同じ候補者に対する評価コメントを並べて比較することで明らかになります。
同じ候補者を評価した複数の面接官のコメントを突き合わせると、「何を見ているか」「どう言語化しているか」の違いが浮き彫りになります。たとえば、ある面接官は候補者の具体的な行動を根拠に記述している一方で、別の面接官は「元気がある」「印象が良い」といった感想にとどまっている、といった差が見えてきます。点数が同じでも根拠が異なれば、評価の再現性は低いと判断できます。
主観的・抽象的なコメントが目立つ面接官には、行動ベースの記述方法を改めてトレーニングしましょう。コメントの質が揃うほど、評価会議での判断は速く、正確になります。
面接評価のばらつきを仕組みで抑えるなら「JAPAN AI HR」
JAPAN AI HRは、求人票作成からスカウト、書類選考、面接評価まで、採用プロセス全体をカバーする採用・人事支援AIプラットフォームです。AI面接機能では、会話フローのテンプレートを作成・管理でき、候補者の回答に応じた深掘り質問にも対応します。STARメソッドに則った評価基準をAIが自動生成できるほか、録画・文字起こしは自動で格納され、人物要約や総合スコア、強み・改善点を一覧化した評価レポートも確認できます。さらに、面接内容を分析して面接官ごとの評価傾向や改善点をフィードバックする機能や、主要なATS(採用管理システム)との連携にも対応しています。評価基準の統一と面接官の育成を同時に進めたい企業は、導入を検討してみてはいかがでしょうか。

AI面接の概要と活用方法を、ひとつの資料で。
書類だけでは見えない
候補者の情報を、
AIが引き出す
面接の準備・実施・評価を
どう効率化できるか、
資料でチェック
✓
対話型AI面接のサービス概要
✓
準備から評価までの効率化イメージ
✓
対話型AI面接のユースケース

面接評価のばらつきに関してよくある質問
面接評価のばらつきの改善に取り組む際に、人事担当者や面接官から寄せられることの多い疑問とその答えをまとめました。自社で対策を進めるときの判断材料としてご活用ください。
面接官研修だけで評価のばらつきは解消できますか?
研修だけでは十分に解消できません。ばらつきの根本原因は仕組みが整っていないことにあるため、評価基準の設計や質問の標準化、評価シートの整備、面接官同士のすり合わせの場と組み合わせて取り組んでください。研修は、これらの仕組みを現場に定着させる手段として位置づけましょう。
面接官同士の評価が大きく割れた場合どう判断すればよいですか?
単純に平均点を取るのではなく、根拠にしている候補者の回答・行動が同じか、評価基準の定義を同じ意味で理解しているか、未確認の項目を懸念として扱っていないかの3点を確認してください。評価が割れた理由を分析すれば、次回以降の評価基準の改善点も明確になります。
質問を統一すると候補者の個性を見落としませんか?
共通質問で比較の前提を揃えたうえで、回答に応じた深掘り質問を加える半構造化面接を取り入れれば、個性を見落とす心配はありません。質問の統一は個性を排除するためではなく、公平に比較するための工夫です。深掘りの自由度を残し、候補者ならではの経験や強みを引き出しましょう。
候補者へのURL送信からAI面接の実施・評価レポート作成、ATS連携まで。24時間365日対応で一次面接を自動化し、評価基準の標準化と選考スピードの向上を実現するAI面接プラットフォーム「JAPAN AI HR」。⇒AI面接サービスの詳細を見る
面接評価のばらつきは仕組みで減らせる
面接評価のばらつきは、面接官のセンスや経験だけの問題ではなく、仕組みと運用の両面から改善できる課題です。本記事で解説した改善策は、次の5つのステップに集約できます。
- 評価項目を3〜5個に絞り、行動ベースで定義する
- 質問を標準化し、全候補者に同じ条件で面接する
- 評価シートを整備し、根拠のある記録を残す
- 面接官トレーニングとキャリブレーションで評価水準を揃える
- データで可視化し、継続的に改善する
すべてを一度に整える必要はありません。まずは自社の評価基準を棚卸しし、「各評価項目の定義を面接官全員が同じ意味で理解しているか」を確認することから始めてみてください。ずれが見つかった項目から順に定義と質問を見直すだけでも、評価の一貫性は着実に高まります。
AIを活用した採用についてさらに詳しく知りたい方は、以下の記事もご覧ください。

JAPAN AIとは
JAPAN AIは、法人向けの国産生成AIプラットフォームです。AIチャット・議事録・エージェントなどのすぐ使える標準機能から、自社専用AIアプリのノーコード開発まで、全部門のAI活用をひとつの基盤で支えます。ジーニーグループのこれまでのDX・AX支援実績をもとに、ツールの提供にとどまらず、活用テーマの設計から現場での定着・成果創出まで専門チームが伴走します。
JAPAN AIの機能・活用事例・料金体系がわかるサービス紹介資料を無料でお送りします。
▼資料イメージ
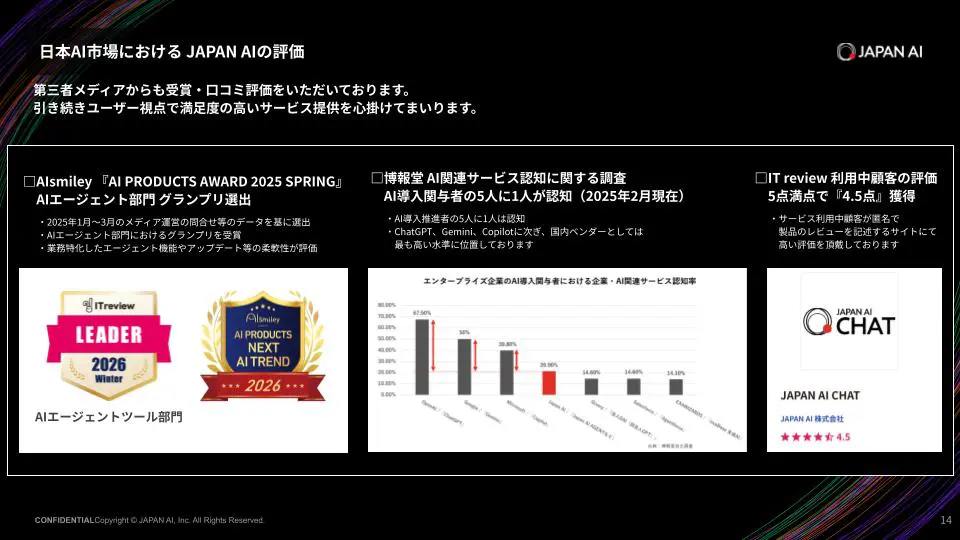
- JAPAN AIでできること(AIチャット/議事録/エージェント/アプリ開発 ほか)
- ChatGPTなど汎用AIツールとの違い
- 業種・部門別の活用シーンと導入事例
- 導入から定着までの支援体制
- 料金体系とセキュリティ・ガバナンス対応
▼簡単1分!JAPAN AIの資料請求