2026年11月9日(米国時間)、AnthropicはClaude 5世代の最上位モデル「Claude Fable 5.2」を正式にリリースしました。Fable 5.1からの料金引き下げや生成速度の向上が注目を集めていますが、「そもそもFable 5.2って何が変わったの?」「Opus 5.5とどう使い分ければいいの?」と疑問に思っている方も多いのではないでしょうか。
この記事では、Claude Fable 5.2の概要・Fable 5.1からの変更点・料金体系・使い方・注意点まで、ClaudeFable 5.2も使える法人向けAIプラットフォームを提供するJAPAN AIが解説します。
\ ChatGPTもClaudeもGeminiも使える! /

Claude Fable 5.2とは?
Claude Fable 5.2は、Anthropicが2026年11月9日にリリースした最新の最上位AIモデルです。Claude 5世代のFableシリーズとしては、Fable 5(2026年6月)→ Fable 5.1 → Fable 5.2と続く第3弾にあたります。
Fable 5.2の基盤にはMythosクラスのモデルが使われており、そこにサイバーセキュリティと生物学分野に関するセーフガード(安全機構)を追加したものがFableです。コンテキストウィンドウは100万トークン、最大出力は128,000トークンで、thinking(推論を行う適応的思考)は常に有効、オフにはできない仕様です。
入力はテキストと画像、出力はテキストであり、信頼できる知識カットオフは2026年6月です。Fable 5.2提供終了は早くても2027年11月9日以降と公式に示されているため、中長期で業務に組み込む場合も前提を立てやすいモデルです。
出典:Anthropic「Claude Fable 5 and Mythos 5 redeployed」/Claude Platform Docs「Claude Fable 5.2 概要」
Claudeシリーズにおける位置付け
Claudeのモデルラインナップは、Haiku・Sonnet・Opus・Fableといった用途の異なるモデルで構成されています。Fableはこの中で、長時間かつ複雑なタスクに特化した性能を備えています。
FableとMythosは同じ基盤モデルを共有していますが、Fableにはサイバーセキュリティと生物学分野のセーフガードが追加されており、これらの分野やフロンティアLLM開発の一部では応答のブロックや下位モデルへの切り替えが起こる場合があります。Mythosは審査済み組織のみが利用できる限定提供モデルです。一方で、FableはClaude Codeと組み合わせて、エージェント的な自律作業にも利用できます。
【関連記事】
Claude Haiku 5.5とは?料金・性能・使い方
Claude Opus 5.5とは?性能・料金・使い方
Claude Sonnet 5.5とは?料金・性能・使い分け
Fable 5.1からの変更点
Claude Fable 5.2のFable 5.1からの主な変更点は、次の3つです。
- API料金の20%引き下げ
- 標準料金のままでの生成速度の向上
- コーディング・推論・視覚認識の性能改善
API料金は、入力が100万トークンあたり$10から$8に、出力が$50から$40に改定され、いずれも20%の値下げです。キャッシュ読み取りも$0.25から$0.20に下がりました。
生成速度は、標準料金のまま出力生成がFable 5.1比で最大30%速くなりました。さらにFast modeを選ぶと最大2.5倍の速度ですが、入力$16・出力$80/100万トークンの別料金です。
性能面では、Anthropicが評価したほぼすべての項目でFable 5.1とOpus 5.5を上回りました。主なベンチマークの結果は次のとおりです。
| 分野(ベンチマーク) | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| エージェント型コーディング(FrontierCode 2.0) | 49.1%(Xhigh) | 32.4%(Xhigh) | 45.5% | 42.8% | 41.1%(Medium) |
| エージェント型コーディング(FrontierSWE v2) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| 業務ワークフロー(AutomationBench) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| コンピュータ操作(OSWorld 2.1) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| エージェント型検索(WANDR) | 82.1% | 68.7% | 72.3% | - | - |
| 実務の代行(Remote Labor Index) | 41.3%(High) | 17.9% | 21.3% | 20.8% | - |
| 分野横断の推論(Humanity’s Last Exam・ツールあり) | 74.2% | 65.6% | 67.7% | 57.2% | - |
| ロボット制御(RoboDojo Sim) | 64.9% | 27.6% | 39.4% | 29.8% | - |
| グラフの読み取り(Chartography・ツールなし) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
伸びが大きいのは、実務の代行を測るRemote Labor Index(17.9%→41.3%)とロボット制御(27.6%→64.9%)で、いずれもFable 5.1の2倍を超えています。一方、業務ワークフローのAutomationBenchではGemini 4 Carbonが上回っており、すべての評価で首位というわけではありません。自社の用途に近いベンチマークでどの程度の差があるかを確認してから導入を判断しましょう。
Fable 5.2はAmazon Bedrock、Google Cloud、Microsoft Foundryでも利用可能です。Google CloudではAnthropic管理とGoogle管理の両方で提供されており、Microsoft FoundryではAnthropicのインフラ上で提供されます。Fable 5.1からはモデルIDを切り替えるだけでおおむね移行できますが(Amazon Bedrockではanthropic.claude-fable-5-2、それ以外のプラットフォームではclaude-fable-5-2)、自前のコードでAPIを呼び出している場合は、破壊的変更への対応も必要です。
出典:Anthropic「Claude Fable 5.2 and Mythos 5.2」/Claude Platform Docs「What’s new in Claude Fable 5.2」
Claude Fable 5.2とMythos 5.2の違い
FableとMythosは別のモデルだと思われがちですが、正確には同じ基盤モデルに異なる安全構成を適用したものです。
中身は同じ、違いは「特定分野のセーフガード」の構成
Fable 5.2とMythos 5.2は同一の基盤モデルを共有しています。両者の違いは、サイバーセキュリティと生物学分野のセーフガードが適用されるかどうかにあります。もちろん、Mythosにも、AI研究開発の一部の話題で下位モデルに切り替える仕組みなど、別のセーフガードはあります。Fable 5.2ではこれらの分野やフロンティアLLM開発の一部で応答のブロックや下位モデルへの切り替えが起こるため、実際に使える性能はMythosより制限されます。
Mythos 5.2は一般には使えない
Mythos 5.2は、Cyber Verification ProgramまたはLife Sciences Verification Programの審査を通過した組織のみがアクセスできる限定提供モデルです。認証済みのサイバーセキュリティ機関やライフサイエンス研究機関などが主な対象であり、一般のAPIやサブスクリプションプランからは利用できません。なお、Fable 5.2とMythos 5.2はどちらもCovered Modelに指定されており、データ保持などの共通ポリシーが適用されます。
Mythos 5.2の強みはサイバーセキュリティで、Anthropicの社内評価「CVE Rediscovery」では、Opus 5.5より10.2%、Mythos 5.1より14.4%多くの脆弱性を見つけています。審査を申請する価値があるのは、脆弱性の発見・再現・修正を業務として行う組織といえます。
また、Claude Enterpriseの顧客であれば、Cyber Verification Programの参加組織でなくても、Mythos 5.2を含む最上位モデルでコードベースの脆弱性をスキャンする「Claude Security」を利用できます。Mythos 5.2を直接使えなくても、脆弱性診断の用途ではその性能を活用する経路がある点は押さえておきましょう。
出典:Anthropic「Claude Fable 5.2 and Mythos 5.2」
Claude Fable 5.2の特徴
Claude Fable 5.2には、他のClaudeモデルとは一線を画す4つの主要な強みがあります。
長時間タスクに強い
Fable 5.2は、長期的な作業に対応しやすい点が最大の特徴です。Anthropicは、Fable 5.2を最も難しく答えの決まっていない技術作業に向くモデルと位置付けており、曖昧なエンジニアリング作業を数日にわたって続けられるとしています。
具体例として、Anthropicのエンジニアが試作OSの設計を任せた実験では、Fable 5.2が空のフォルダから1,000を超えるサブエージェントを指揮し、8日間にわたってコードの作成・テスト・レビューを続けました。完成したOSはノートPCで起動し、ディスク・キーボード・ネットワークのドライバーやファイル保存、ログイン画面、インストーラーまで備えています。
数学では、約1,000のFable 5.2エージェントがフェルマーの最終定理の証明を、人の介入をほとんど受けずに30時間で形式化(コンピューターが検証できる言語への書き換え)しました。同じ構成のOpus 5.5は、18時間で全体の26%までしか進んでいません。人が張り付かなくても、数日単位の作業を最後まで進められることが、他のモデルとの大きな違いです。
コーディング性能
Fable 5.2は、実際の開発現場で採用される品質のコードを書ける点が評価されています。オープンソースのメンテナーにマージされるかどうかを測るFrontierCode 2.0では、Xhigh effortで49.1%と、Anthropicがテストした公開済みモデルの中で最高のスコアでした。
Anthropic社内では、中核コードベースにマージされる変更の90%以上を、人の指示のもとでClaudeが書いています。Fable 5.2の初期版で動くエージェントのチームは、重要な本番サービスをPythonからRustへ移行し、起動時間を約26倍速くしました。Claude Codeでも利用できるため(バージョン2.1.321以降)、手間や費用の面で後回しにしていた大規模な移行や改修に着手しやすくなります。
エージェント性能
複数の工程にまたがるタスクを、人の介入を最小限に抑えて自律的に進められるエージェント性能も大きな強みです。FrontierCode 2.0はXhigh effortで49.1%(High effortではOpus 5.5の最高点とほぼ同水準)、FrontierSWE v2は69.9%と、いずれも公式表の最高effort側の値でエージェント系ベンチマークにおいて、AutomationBenchなど一部の評価では他社モデルが上回っているものの高いスコアを収めています。実務の代行を測るRemote Labor Indexでも41.3%と、Fable 5.1の17.9%から大きく伸びました。
先行利用した企業の事例では、Uberのエンジニアが10〜12時間のセキュリティ監査をFable 5.2に任せたところ、約170のレビュー用エージェントを動かし、報告書と修正のプルリクエスト、ポリシー案までまとめて返してきたと報告されています。途中で区切らず、作業が実際に終わるまで自走する点が、長時間の無人運用に向く理由です。
ビジョン性能(画像理解)
Fable 5.2は、細かい画像やPDFを読み取れます。5.2では視覚認識が改善されており、グラフや図表の読み取り精度を測るChartography(ツールなし)では73.4%と、Fable 5.1の44.8%から大きく向上し、GPT-6 Astra(71.0%)やGemini 4 Carbon(72.5%)も上回りました。
先行利用したUnityは、視覚的な参照をもとに体験を再構築する作業や、3Dシーンをゼロから作る作業で、従来モデルより高い品質が得られたと評価しています。資料のグラフや画面の見た目を正確に読み取り、作業に反映できるため、レポートの読解や画面の再現といった用途で効果を期待できます。
出典:Anthropic「Claude Fable 5.2 and Mythos 5.2」/Anthropic「Claude Fable」
Claude Fable 5.2の料金・価格
Fable 5.2の料金は、5/5.1から引き下げられています。以下はAPI利用時の料金体系と、サブスクリプションプランごとの利用条件です。
APIの料金
| 項目 | 料金(100万トークンあたり) |
|---|---|
| 入力 | $8(5/5.1は$10) |
| 出力 | $40(5/5.1は$50) |
| Fast mode 入力 | $16 |
| Fast mode 出力 | $80 |
| Batch API 入力 | $4 |
| Batch API 出力 | $20 |
| キャッシュ書き込み(5分間) | $10.00 |
| キャッシュ書き込み(1時間) | $16.00 |
| キャッシュ読み取り | $0.20(5.1は$0.25、5は$1) |
5/5.1と比較すると入力・出力ともに20%の引き下げです。急ぎでない大量処理はBatch APIを使うと半額に抑えられます。Fast modeを利用すると最大2.5倍の速度が得られますが、料金は標準の2倍になる点に注意しましょう。Fast modeはClaude APIのMessages APIに加え、Google Cloud(Anthropic管理・Google管理)でも利用でき、Microsoft Foundryでは別モデルclaude-fable-5-2-fastとして提供されます。
Opus 5.5(入力$4・出力$20)と比べると、トークン単価は2倍です。ただし、Anthropicの評価ではeffort(推論の深さ)の設定次第で、タスクあたりの費用がOpus 5.5を下回る場面もあります。単価だけでなく、タスク1件あたりの費用で比較することが、正しいコスト判断につながります。
出典:Claude Platform Docs「Pricing」/Claude Platform Docs「What’s new in Claude Fable 5.2」
サブスクの場合(Pro / Max / Ultra / Team / Enterprise)
| プラン | Fable 5.2の利用条件 |
|---|---|
| Max / Ultra | 週間使用量の50%までFable利用可能(追加料金なし)。超過分は使用量クレジットで継続可能 |
| Pro | 通常は使用量クレジット(従量課金)で利用。ただし2026年11月16日(米国太平洋時間)まではローンチオファーで週間使用量の50%まで追加料金なし |
| Team | プレミアムシートはMaxと同様。標準シートはProと同様 |
| Enterprise | legacyシート制のプレミアムシートは50%まで込み。標準シートは使用量クレジット(管理者が有効化した場合)。利用量ベース契約はAPI標準料金 |
Freeプラン(無料版)ではFable 5.2は利用できません。また、Fableモデルは他のClaudeモデルより速いペースで使用量の上限を消費します。Max・Ultraなどでも、Fableを多用すると週の上限に早く達するため、設定画面の使用量の表示をこまめに確認しましょう。
出典:Claude Help Center「Claude Fable models on your plan」

ローンチオファー
Fable 5.2のリリースにあわせて、以下のローンチオファーが提供されています。ProとTeam標準シートでは、米国太平洋時間で2026年11月16日まで、週間使用量の50%までFableを追加料金なしで利用できます。2026年11月9日午前10時より前から有料課金があるアカウントには、Fableの使用量リセットも1回付与されます。ただし、2026年11月16日午後11時59分に失効してしまうので注意が必要です。
Fableリセットの対象は、Max・Ultra・Teamプレミアムシート・legacyのシート制Enterpriseプレミアムシートで、2026年11月9日午前10時(米国太平洋時間)より前から有料課金があるアカウントです。回数は有料契約期間に応じて決まり、6か月未満で1回、6〜12か月で2回、12か月超で3回と決まっています。
Free・legacyシート制の標準シート・self-serve Enterprise・利用量ベースEnterprise・HIPAA-ready Enterpriseはリセットの対象外です。最新の条件についてはAnthropic公式サイトでご確認ください。
出典:Claude Help Center「Claude Fable 5.2 launch offers」
Claude Fable 5.2の使い方・対応プラットフォーム
Fable 5.2は複数の方法で利用できます。利用環境に応じて最適なアクセス方法を選択してください。
claude.aiからの直接アクセス
最もシンプルな方法は、デスクトップ版・モバイル版アプリにて有料プランのモデルピッカーからFable 5.2を選択する方法です。Freeプランでは利用できません。また、Enterpriseでは、管理者が有効にするまでFable 5.2は表示されません。ただし、リリースから7日後には、既存のFableモデルが有効になっているロールにFable 5.2が自動で追加されます(既定モデルがFableの場合はFable 5.2に切り替わります)。管理者が事前にオプトアウトすれば、自動追加は行われません。thinking(推論を行う適応的思考)は常に有効で、オフにはできません。推論の深さはeffortで調整でき、Claudeアプリの既定はMediumです。
API・エンタープライズプラットフォーム
開発者やエンタープライズ環境で利用する場合は、APIのモデルIDを指定してリクエストを送信します。Amazon Bedrockではanthropic.claude-fable-5-2、それ以外のプラットフォーム(Claude API、Claude Platform on AWS、Google Cloud、Microsoft Foundry)ではclaude-fable-5-2を使用します。Google CloudではAnthropic管理とGoogle管理の両方で提供されており、Microsoft FoundryではAnthropicのインフラ上で提供されます。
APIではeffortをlow・medium・high・xhigh・maxの5段階で指定でき、既定はhighです。公式は、性能向上の大半はhighの時点で得られるとしており、まずhighから始めることを勧めています。効果を測定できた難度の高い長時間のコーディングやエージェント作業ではxhighに上げ、maxは性能の上限を測る場合や、時間とトークンを気にしなくてよいまれなタスクに限って使いましょう。
Claude Codeではバージョン2.1.321以降が必要です。事前にアップデートしておきましょう。
出典:Claude Platform Docs「What’s new in Claude Fable 5.2」/Claude Help Center「Claude Fable models on your plan」
Fable 5.1・Opusから移行する際の注意点
自前のコードでAPIを呼び出している場合、Fable 5.1からClaude Fable 5.2への移行では、次の4つの破壊的変更でエラーが起きる可能性があります。
- prefix check(会話履歴の編集チェック)が全アカウントに適用され、過去のターンを書き換えると400エラーになる
- Fable 5.2のthinkingブロックを読めるのはFable 5.2とMythos 5.2だけで、Fable 5.1やOpus 5.5、フォールバック先のOpus 4.8・Opus 5は読めない
- Amazon Bedrock以外では、旧computer useツール(
computer_20251124)が使えない - advisorツールでFable 5.2を実行役にする場合、助言役もFable 5.2かMythos 5.2にする必要がある
prefix checkが全アカウントに広がった背景には、蒸留攻撃(高性能モデルの出力を別モデルの学習に流用する行為)への対策があります。過去の文脈を書き換えて推論内容を引き出す手口を防ぐ仕組みで、Anthropicは一連の対策により、蒸留を試みる側が収集できるデータを90〜99%減らしたとしています。Claude Code、claude.ai、Claude Managed Agents、Claude Agent SDKがリクエストを組み立てている場合は、対応は不要です。
Opusモデルから移行する場合は、APIの仕様にも注意してください。tool_choiceで特定ツールの使用を強制する指定(anyやtool)は400エラーを返すため、autoのままstrict tool useやJSON出力を使います。thinkingを無効にする指定やbudget_tokensの指定もエラーになり、temperature・top_p・top_kは省略が推奨されています。
コードを変えなくても現れる挙動の違いもあります。プロンプトで「考えずに答えて」と指示しても、medium以上のeffortでは推論を省かず、high以上ではほぼすべての応答の前に推論します。また、長い多段階タスクではlowやmediumのときに、残作業の一覧を示して途中でターンを終えることがあります。移行時はモデルIDの変更だけで済ませず、effortを変えながら評価をやり直すことで、想定外のコスト増や作業の打ち切りを防げます。
出典:Claude Platform Docs「What’s new in Claude Fable 5.2」/Anthropic「Claude Fable 5.2 and Mythos 5.2」
セーフガードの仕組み
Fable 5.2には段階的なセーフガード(安全装置)が組み込まれており、利用中にその挙動に遭遇することがあります。あらかじめ仕組みを把握しておくことで、意図しない応答に戸惑わずに済みます。
高リスク分野には利用制限がある
Fable 5.2のセーフガードには、リクエストの内容に応じた段階的な対応が組み込まれています。エクスプロイトやマルウェアの作成など、攻撃的なサイバー技術に関するリクエストにはOpus 4.8が、生物・化学・ライフサイエンスやフロンティアLLM開発の分野ではOpus 5が代わりに応答する仕組みです。日常的なセキュリティ作業にはFableも対応するものの、切り替えが起こりやすいとされています。ただし、思考内容を引き出そうとする要求などは、フォールバックなしでそのままブロックされます。
Claudeアプリ(Web・デスクトップ・モバイル・Claude Code)では、この自動切り替えが初期状態で有効です(設定で無効にもできます)。一方、APIでは初期状態ではフォールバックが発生せず、stop_reason: "refusal"がそのまま返ります。APIでフォールバックを利用するには、fallbacksパラメータ(Claude APIおよびGoogle CloudのAnthropic管理で提供されるベータ機能)かSDKのミドルウェアで設定する必要があります。
なお、出力前の拒否は、生物・蒸留・フロンティアLLM開発の分類では課金され、それ以外では課金されません。アプリで自動切替した場合、またはAPIでフォールバックを設定した場合は、切替先の応答が別途課金されます。切替に伴うキャッシュミスにはクレジットがあります。
無害な質問であっても分類器が誤検知するケースはありますが、Fable 5.2ではFable 5.1と比べて不要なブロックが約55%減りました(サイバー分野で約60%、生物分野で約40%の減少)。注意したいのは、判定の対象が直近のメッセージだけではない点です。メモリやコネクタ経由の情報、Web検索の結果、添付ファイルなど、モデルが読み込むすべての内容が確認されるため、自分で入力していない内容が原因で切り替わることもあります。業務資料を読み込ませた際に切り替えが起きたら、入力文だけでなく参照データも見直すと原因を特定しやすくなります。
出典:Claude Help Center「Why Claude switched models in your conversation with Fable models」/Anthropic「Claude Fable 5.2 and Mythos 5.2」
Opus・Sonnetとの使い分け
Fable 5.2がリリースされたとはいえ、すべてのタスクにFableを使えばよいわけではありません。公式も、日常的なコーディングや知識作業の大半では、まずOpus 5.5から使い始めることを勧めています。以下の使い分けを基本方針としてください。
| モデル | 推奨シーン | 料金感(100万トークンあたり) |
|---|---|---|
| Haiku 5.5 | 分類・抽出・ルーティングなど大量・低遅延の処理 | 入力$0.10(10万トークン以下)または$0.50(超)/ 出力$0.50または$2.50 |
| Sonnet 5.5 | 速度と性能のバランスが必要な一般的タスク | 入力$2 / 出力$10 |
| Opus 5.5 | 日常的な文章作成・調査・コード修正・会話 | 入力$4 / 出力$20 |
| Fable 5.2 | 大規模コード移行、複数日がかりの自律作業、原因不明のバグ調査、複雑なリサーチ | 入力$8 / 出力$40 |
日常的なチャット、メール文案の作成、ちょっとしたコードの修正程度であれば、Opus 5.5で十分な品質が得られます。Fable 5.2は、「Opusでは精度が足りない」「長期にわたるタスクを自律的に処理させたい」といった、ここぞという場面に限定して投入するのがコスト効率の面で合理的です。
判断の際は、トークン単価だけでなくeffortとの組み合わせで考えることが重要です。Anthropicの評価では、FrontierCode 2.0でHigh effortのFable 5.2が45.3%と、Max effortのOpus 5.5の45.5%とほぼ同じスコアを、タスクあたり約半分の費用で達成しました。Humanity’s Last ExamではLow effortのFable 5.2がOpus 5.5の最高点に並び、費用は10分の1未満でした。Opus 5.5のeffortを最大まで上げても精度が足りない場合は、Fable 5.2を低めのeffortで試すと、品質と費用の両方を改善できる可能性があります。
会話全体をFableに任せない使い方もあります。Haiku・Sonnet・Opusが難所だけFable 5.2に相談する「Advisor(助言役)」と、Fable 5.2が簡単な作業を小さなモデルに割り振る「Orchestrator(指揮役)」です。Claude Codeで大規模なリファクタリングを実行する場合や、大きなコードベースを横断して分析する場合などは、Fable 5.2の本領を発揮する典型的なユースケースです。こうした場面でも、判断が必要な部分だけFableに担わせる構成にすれば、費用と待ち時間を抑えられます。
出典:Anthropic「Claude Fable 5.2 and Mythos 5.2」/Claude Platform Docs「Pricing」
Claude Fable 5.2の注意点
Fable 5.2を導入する前に、以下の2つの制約事項は把握しておきましょう。
利用料金が高い
Opus 5.5と比較して、トークン単価は入力・出力ともに2倍です。effortの設定次第でタスクあたりの費用がOpus 5.5を下回る場面はあるものの、high以上のeffortではほぼすべての応答の前に推論し、サブエージェントを多用する作業では費用がかさみやすい傾向もあります。すべてのタスクをFable 5.2に振り向けると、月間のAPI費用はかなりの額に膨らむ可能性があります。高性能なモデルほど「使わない判断」が重要です。軽い質問やルーティン作業はHaikuやSonnet、Opusに任せ、Fableは本当に必要な場面に絞る運用でコストを管理しましょう。
30日間のデータ保持
Covered Modelsに指定されているFableおよびMythosでは、安全監視のために入出力データが最低30日間保持されます(安全調査の対象になった場合などは、それより長くなることがあります)。Covered Modelsでは原則としてゼロデータ保持(ZDR)を利用できません。ZDRが必要な組織向けには、監視用の保持データを自社管理のクラウドに置けるEnterprise Frontier Safeguards(EFS)が用意されています。
EFSは2026年秋から段階的に提供されており、2026年11月9日時点ではprivate betaです。対象となる顧客は、EFSで監視を実装するまでの期間限定で、自社の社内業務アプリケーションに限りZDRを利用できる移行措置があります。
法人での利用を検討している場合は、自社のセキュリティポリシーやデータガバナンス要件との整合性を事前に確認しておく必要があります。HIPAA対応では、AnthropicのBAA(事業提携契約)の範囲でCovered Modelsを使える経路が、HIPAA-ready API、HIPAA-ready Enterpriseのチャット、HIPAA設定を適用したClaude Code・Coworkのローカルモードに限られます。ZDRを有効にした組織からは利用できず、他社クラウド経由の利用はAnthropicのBAAの対象外です。機密性の高い情報をFable 5.2に入力する際は、このデータ保持の仕様を十分理解したうえで判断してください。
出典:Claude Help Center「Covered Models」/Claude Help Center「Covered Models under a Business Associate Agreement (BAA)」/Anthropic「Claude Fable 5.2 and Mythos 5.2」
Claude Fable 5.2に関するよくある質問
Claude Fable 5.2とFable 5.1の違いは何ですか?
主な違いは、料金の引き下げ、生成速度の向上、性能の改善の3点です。API料金は入力$10→$8、出力$50→$40に引き下げられ、キャッシュ読み取りも$0.25→$0.20になりました。標準料金のまま生成速度が最大30%向上し、コーディング・推論・視覚認識の性能も改善されています。なお、APIモデルIDは「claude-fable-5-2」に変わります。
Claude Fable 5.2はどのプランで使えますか?
Pro、Max、Ultra、Team、Enterpriseの有料プランで利用できます。Freeプラン(無料版)では利用できません。Max・Ultra、およびTeamプレミアムシート・legacyシート制Enterpriseのプレミアムシートでは、週間使用量の50%までFableを追加費用なしで使えます。ProとTeam標準シートは通常は使用量クレジットが必要ですが、2026年11月16日まではローンチオファーで50%まで追加費用なしで使えます。
Claude Fable 5.2を毎日使うべきですか?
日常的なタスクにはOpus 5.5を使い、Fable 5.2は大規模なコード移行や複数日がかりの自律作業、原因究明が困難な複雑な問題など、高難度タスクに限定して使うのがコスト面で合理的です。公式も、まずOpusモデルで評価し、effortを上げても要件を満たせない場合にFable 5.2へ移ることを推奨しています。
Fable 5.2の登場後もFable 5.1は使えますか?
使えます。2026年11月10日時点で、Fable 5.2・Fable 5.1・Fable 5はいずれも有料プランのモデルピッカーから選択でき、APIでも利用できます。既存のワークフローは5.1のまま維持し、新しいタスクから順にFable 5.2で検証してください。
Claude Fable 5.2は「ここぞ」で使う最上位モデル
Claude Fable 5.2は、Fable 5.1から料金が20%引き下げられ、生成速度も最大30%向上したことで、以前よりも導入のハードルが下がりました。しかし、Opus 5.5と比較するとトークン単価は依然として2倍のため、すべてのタスクにFableを使うのは現実的ではありません。
日常の業務にはOpus 5.5を基本として使い、大規模で複雑なタスク、すなわち大規模なコードベースの移行、複数日がかりの自律リサーチ、Opusでは精度が出ない難問にFable 5.2を投入するのが、性能とコストのバランスを取る実務上の最適解です。effortを抑えた設定や、難所だけをFableに任せるAdvisorの使い方を組み合わせれば、タスクあたりの費用を抑えながら最上位モデルの性能を引き出せます。
まずはローンチオファー期間を活用して小さなタスクで試し、品質とコストを検証してから本番投入を判断しましょう。
JAPAN AIとは
JAPAN AIは、法人向けの国産生成AIプラットフォームです。AIチャット・議事録・エージェントなどのすぐ使える標準機能から、自社専用AIアプリのノーコード開発まで、全部門のAI活用をひとつの基盤で支えます。ジーニーグループのこれまでのDX・AX支援実績をもとに、ツールの提供にとどまらず、活用テーマの設計から現場での定着・成果創出まで専門チームが伴走します。
JAPAN AIの機能・活用事例・料金体系がわかるサービス紹介資料を無料でお送りします。
▼資料イメージ
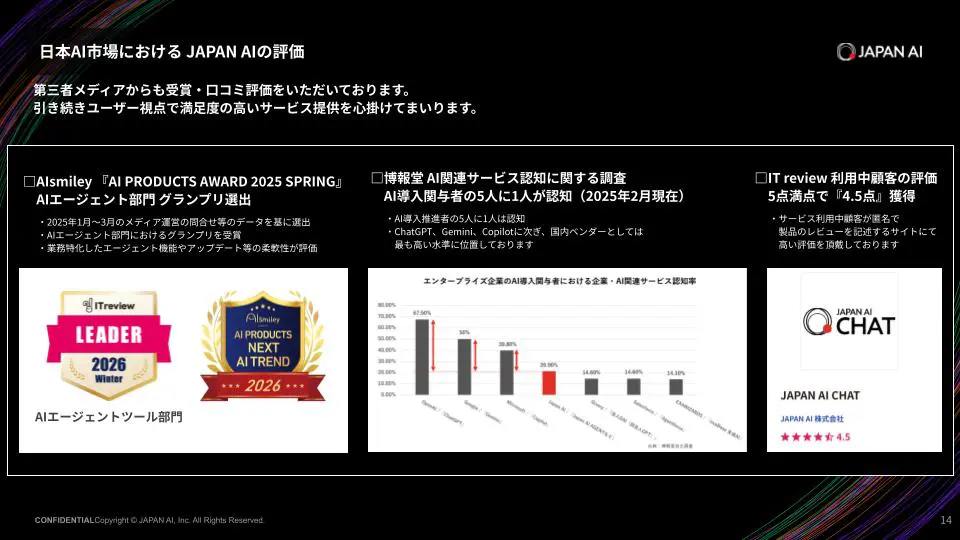
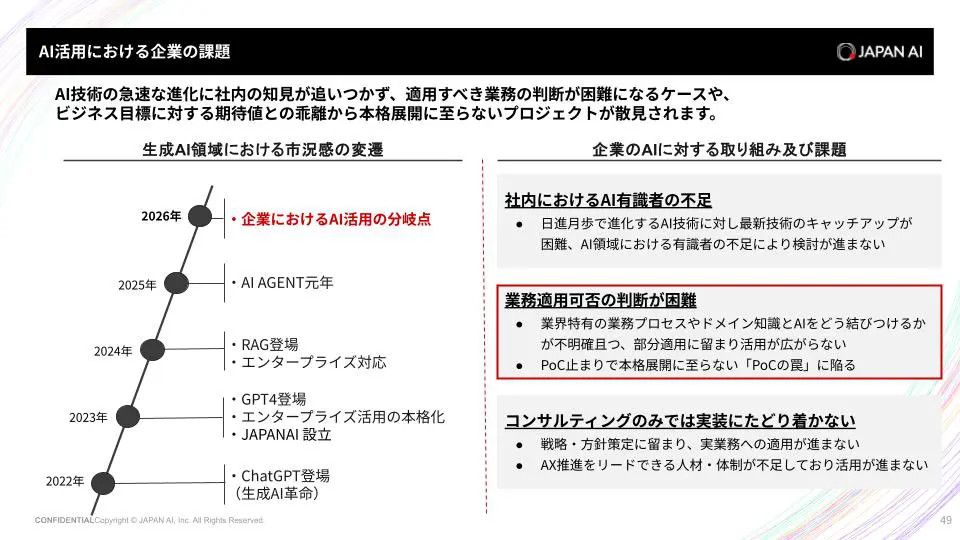
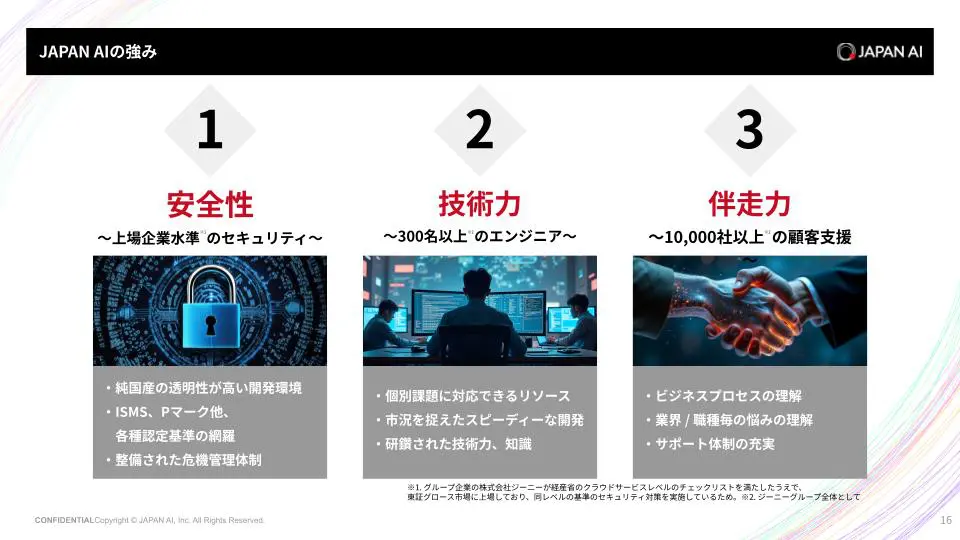
- JAPAN AIでできること(AIチャット/議事録/エージェント/アプリ開発 ほか)
- ChatGPTなど汎用AIツールとの違い
- 業種・部門別の活用シーンと導入事例
- 導入から定着までの支援体制
- 料金体系とセキュリティ・ガバナンス対応
▼簡単1分!JAPAN AIの資料請求